A pergunta antes do código
A pergunta é das mais comuns em ecologia: o habitat alterado tem menos espécies do que o preservado? Você coletou nos dois, contou as espécies e encontrou 49 num e 80 no outro. Parece resolvido.
Antes de escrever “a riqueza foi 63% maior”, pergunte quantos indivíduos e quantas amostras você tem em cada área. Se o número for diferente, a comparação ainda não diz nada. Magurran (2004, p. 76, 99) aponta a dependência do esforço como o problema mais pesado das medidas de riqueza, e a lógica é simples: quanto mais você coleta, mais espécies raras aparecem. A curva de acumulação de espécies mostra isso em qualquer dado.
Como o erro aparece
A simulação abaixo cria uma única comunidade de 120 espécies, com poucas espécies comuns e muitas raras. Depois coleta 150 indivíduos numa “mata A” e 450 numa “mata B”. As duas matas são a mesma comunidade; só o esforço muda. Os dados são simulados para mostrar o problema que um dado real esconderia, porque no dado real você nunca sabe a riqueza verdadeira.
library(vegan)     # versão usada: 2.6-4
library(iNEXT)     # versão usada: 3.0.2
library(ggplot2)

set.seed(10)
p <- rlnorm(120, meanlog = 0, sdlog = 1.8)  # abundâncias desiguais, como na natureza
p <- p / sum(p)                             # proporção de cada espécie

coleta <- function(n) {                     # sorteia n indivíduos da comunidade
  tabulate(sample(120, n, replace = TRUE, prob = p), nbins = 120)
}
mata_a <- coleta(150)
mata_b <- coleta(450)

c(mata_a = sum(mata_a > 0), mata_b = sum(mata_b > 0))
mata_a mata_b
    49     80
A mata A tem 49 espécies; a mata B, 80. Uma diferença de 31 espécies entre duas amostras da mesma comunidade. Se você tivesse feito um teste, ela provavelmente seria “significativa”, e o resultado seria um artefato do esforço.
Por que é um problema: rarefação no mesmo esforço
A rarefação responde: quantas espécies a amostra maior teria se tivesse só o tamanho da menor? Ela é a curva de acumulação lida ao contrário, da direita para a esquerda (Gotelli; Colwell, 2001; Magurran, 2004, p. 144).
rarefy(rbind(mata_a, mata_b), sample = 150, se = TRUE)
   mata_a    mata_b
S      49 52.738792
se      0  3.154667
attr(,"Subsample")
[1] 150
- Coluna
mata_a: S = 49, se = 0. A mata A já tem 150 indivíduos, então não há o que rarefazer, e o erro-padrão é zero. - Coluna
mata_b: S = 52,7, se = 3,2. Com 150 indivíduos, a mata B teria, em média, 52,7 espécies. A diferença cai de 31 para menos de 4 espécies, pouco mais de um erro-padrão. attr(,"Subsample")= 150. O tamanho para o qual tudo foi rarefeito. Confira se é o da menor amostra.
Quando as curvas se cruzam
Rarefazer até a menor amostra resolve o esforço, mas não resolve tudo. Duas comunidades podem trocar de posição conforme o esforço. Lande, DeVries e Walla (2000) mostraram isso com borboletas: uma comunidade perturbada, com mais espécies e mais dominância, parecia mais pobre em amostras pequenas e mais rica em amostras grandes (Magurran, 2004, p. 95).
A segunda simulação cria uma comunidade rica e desigual (150 espécies, poucas dominantes) e uma pobre e uniforme (45 espécies igualmente comuns), com 2.000 indivíduos cada.
set.seed(11)
p_rica <- rlnorm(150, meanlog = 0, sdlog = 2.2); p_rica <- p_rica / sum(p_rica)
rica    <- tabulate(sample(150, 2000, replace = TRUE, prob = p_rica), nbins = 150)
uniforme <- tabulate(sample(45, 2000, replace = TRUE), nbins = 45)

comunidades <- rbind(rica = c(rica), uniforme = c(uniforme, rep(0, 105)))
tamanhos <- c(25, 50, 100, 200, 400, 800, 2000)
# o vegan pode avisar que a menor contagem não é 1: na comunidade uniforme não há espécies raras
round(sapply(tamanhos, function(n) rarefy(comunidades, sample = n)), 1)
         [,1] [,2] [,3] [,4] [,5] [,6] [,7]
rica     13.5 20.8 30.9 43.7 59.4 77.6  102
uniforme 19.3 30.4 40.2 44.5 45.0 45.0   45
n_seq <- seq(10, 2000, by = 10)
rar <- data.frame(
  individuos = rep(n_seq, 2),
  riqueza = c(rarefy(rica, n_seq), rarefy(uniforme, n_seq)),
  comunidade = rep(c("Rica e desigual", "Pobre e uniforme"), each = length(n_seq))
)
ggplot(rar, aes(individuos, riqueza, linetype = comunidade)) +
  geom_line(linewidth = 0.9) +
  labs(x = "Número de indivíduos", y = "Espécies esperadas (rarefação)",
       linetype = NULL)
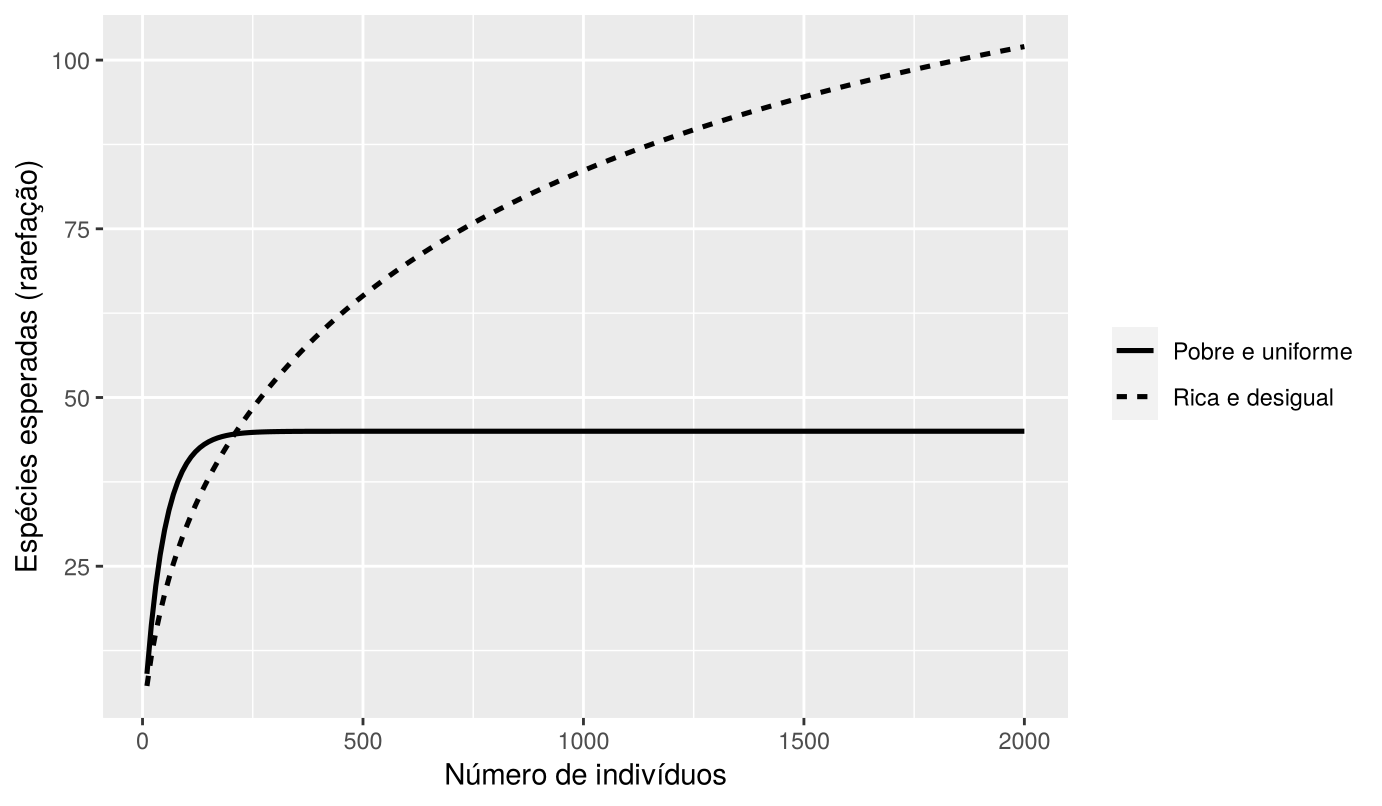
Na tabela, as colunas são os tamanhos de 25 a 2.000 indivíduos. Com 100 indivíduos, a comunidade uniforme tem 40,2 espécies e a desigual, 30,9. Com 2.000, a desigual tem 102 e a uniforme fica nas suas 45. Se você rarefizer as duas até 100 indivíduos, vai concluir o contrário do que é verdade para a comunidade inteira.
Como reconhecer no seu desenho ou nos seus dados
Responda a estas perguntas antes de comparar números de espécies:
- O número de indivíduos coletados difere entre as áreas? Se a maior tem mais que o dobro da menor, desconfie de qualquer diferença bruta.
- O número de armadilhas, de parcelas ou de dias de coleta difere?
- As curvas de acumulação das áreas chegaram a uma assíntota? Se nenhuma chegou, a riqueza observada de todas depende do esforço.
- O método de coleta foi o mesmo em todas as áreas? Se não, nenhuma correção posterior resolve (Magurran, 2004, p. 144).
- A dominância parece muito diferente entre as áreas? Se sim, as curvas podem se cruzar.
Como corrigir: o exemplo com aranhas
Agora com dado real. O pacote iNEXT traz contagens de aranhas em dois tratamentos de um experimento de remoção de Tsuga canadensis em Harvard Forest, nos Estados Unidos (Sackett et al., 2011): árvores aneladas (Girdled) e cortadas (Logged). O dado é distribuído com o pacote, sob licença GPL (≥ 3).
data(spider)
sapply(spider, function(x) c(especies = length(x), individuos = sum(x)))
           Girdled Logged
especies        26     37
individuos     168    252
O tratamento Logged tem 37 espécies em 252 indivíduos; o Girdled, 26 em 168. São 11 espécies e 84 indivíduos de diferença. Quanto da primeira diferença é a segunda?
Rarefação até a menor amostra
rarefy(spider$Logged, sample = 168, se = TRUE)
        [,1]
S  31.707329
se  1.842519
attr(,"Subsample")
[1] 168
Com 168 indivíduos, o tratamento Logged teria 31,7 espécies (erro-padrão 1,8). A diferença cai de 11 para cerca de 6 espécies. Parte da vantagem era esforço; parte parece real.
Rarefação e extrapolação com intervalos
O iNEXT faz a rarefação, estende a curva por extrapolação e calcula intervalos de confiança por bootstrap (Chao et al., 2014; Hsieh; Ma; Chao, 2016).
set.seed(4)  # os intervalos vêm de bootstrap
curvas <- iNEXT(spider, q = 0, datatype = "abundance", endpoint = 500)

set.seed(4)
estimateD(spider, q = 0, datatype = "abundance", base = "size", level = 168)
  Assemblage   m      Method Order.q        SC       qD   qD.LCL   qD.UCL
1    Girdled 168    Observed       0 0.9288554 26.00000 21.03074 30.96926
2     Logged 168 Rarefaction       0 0.9267553 31.70733 27.48862 35.92604
- Linha
Girdled,Method= Observed: 26 espécies, intervalo de 21,0 a 31,0. É a amostra real, com o intervalo do que outra amostra do mesmo tamanho daria. - Linha
Logged,Method= Rarefaction: 31,7 espécies, intervalo de 27,5 a 35,9. O mesmo valor dorarefy(), agora com intervalo. - Coluna
SC: 0,93 nos dois. No tamanho de 168 indivíduos, as duas amostras têm a mesma cobertura, então a comparação também é justa em completude (Chao; Jost, 2012).
est <- curvas$iNextEst$size_based
est$trecho <- ifelse(est$Method == "Extrapolation", "Extrapolação", "Rarefação")
obs <- subset(est, Method == "Observed")
obs$trecho <- "Extrapolação"            # repete o ponto observado para ligar os dois trechos
est <- rbind(est, obs)

ggplot(est, aes(m, qD)) +
  geom_ribbon(aes(ymin = qD.LCL, ymax = qD.UCL, group = Assemblage), alpha = 0.2) +
  geom_line(aes(linetype = trecho, group = interaction(Assemblage, trecho)),
            linewidth = 0.9) +
  geom_point(data = subset(est, Method == "Observed"), size = 3) +
  annotate("text", x = 480, y = c(37, 50), label = c("Girdled", "Logged"), hjust = 1) +
  scale_linetype_manual(values = c("Rarefação" = "solid", "Extrapolação" = "dashed")) +
  labs(x = "Número de indivíduos", y = "Riqueza de espécies", linetype = NULL)
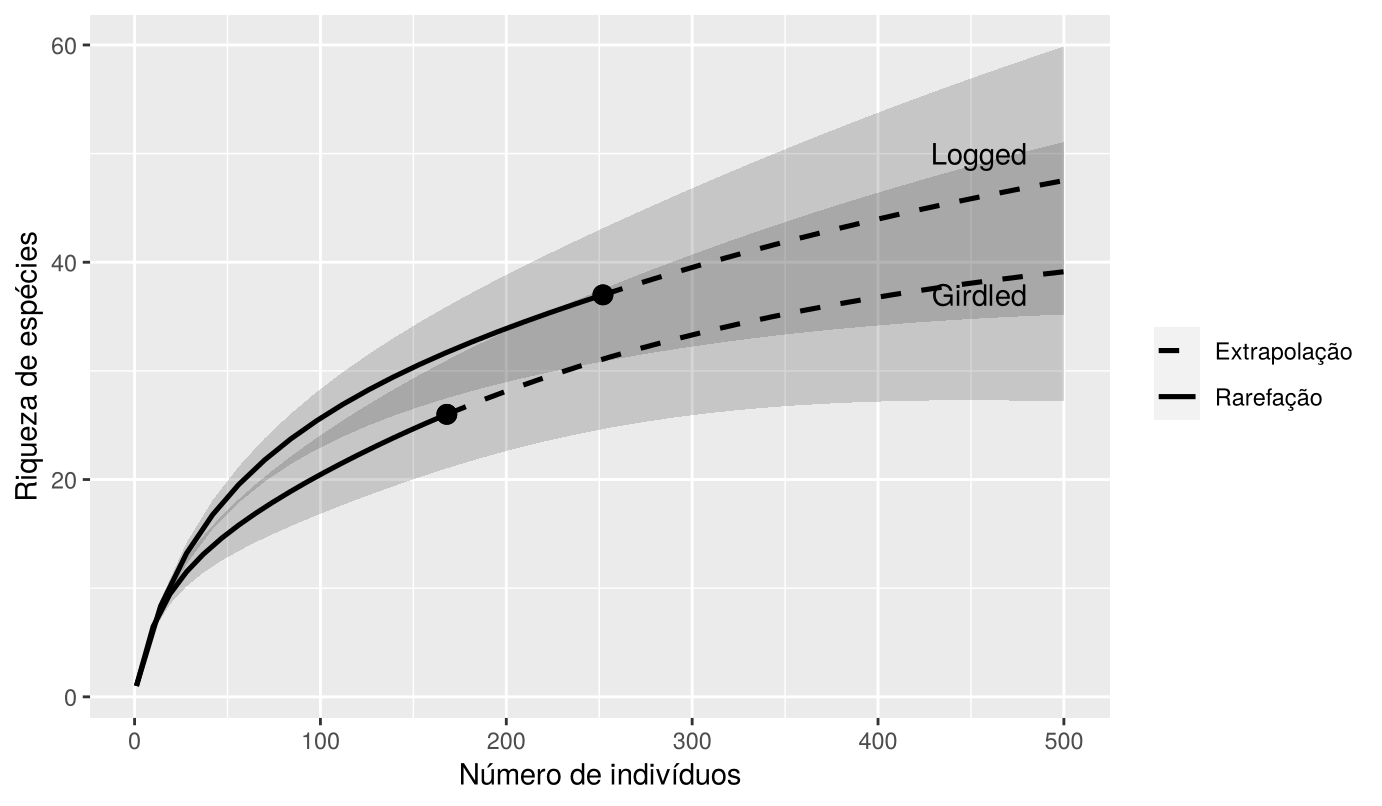
Como ler isso? O critério que Magurran (2004, p. 147) descreve é ver se a riqueza observada da amostra menor cai dentro do intervalo da curva rarefeita da maior. Aqui, 26 fica abaixo de 27,5, fora do intervalo. Mas esse critério ignora a incerteza da amostra menor; olhando os dois intervalos, eles se sobrepõem entre 27,5 e 31,0. A leitura honesta: no mesmo esforço, o tratamento Logged tende a ter mais espécies, mas a diferença é moderada.
E há um limite que nenhuma curva resolve: são um local por tratamento. A comparação diz que essas duas amostras diferem, não que cortar árvores aumenta a riqueza de aranhas. Para isso, você precisaria de vários locais por tratamento.
Se a sua comparação tem esforços diferentes e você não sabe se a diferença sobrevive à rarefação, é exatamente esse tipo de dúvida que resolvemos numa consultoria.
Quando não é esse problema
Nem toda diferença de esforço invalida a comparação. Você pode comparar a riqueza observada quando as curvas de acumulação das áreas chegaram claramente a uma assíntota: aí o esforço extra não acrescenta espécies. Também é legítimo quando a sua pergunta é sobre densidade de espécies, como espécies por armadilha ou por metro quadrado, e o esforço por unidade foi o mesmo. Magurran (2004, p. 75-76) distingue essa medida da riqueza por número de indivíduos, e as duas respondem perguntas diferentes.
Um cuidado nesse último caso: se a densidade de indivíduos difere muito entre as áreas, a densidade de espécies acompanha. Em florestas exploradas, por exemplo, diferenças de riqueza por área podem sumir quando você corrige pela densidade de árvores (Cannon et al., 1998, apud Magurran, 2004, p. 132). Diga qual das duas você está comparando.
Onde a rarefação falha
A rarefação supõe que as duas amostras vêm do mesmo método e que os indivíduos foram amostrados ao acaso. Com indivíduos agregados, a rarefação por indivíduos superestima a riqueza (Magurran, 2004, p. 144); por isso, com armadilhas, a rarefação por amostras costuma ser a escolha mais segura. E ela não recupera o que a coleta não pegou: se a amostragem foi insuficiente, nenhuma rarefação compensa (Magurran, 2004, p. 148).
O cruzamento das curvas mostra outro limite: a riqueza é a medida mais sensível ao esforço. Lande, DeVries e Walla (2000) recomendam relatar também uma medida de diversidade que dê peso às espécies comuns, como o inverso de Simpson, que ordena as comunidades com amostras muito menores. Nas aranhas, a ordem se inverte: no mesmo esforço, o Girdled tem o inverso de Simpson maior. A escolha entre essas medidas tem um post só para ela.
Como escrever a comparação de riqueza na dissertação
O número de reamostragens bootstrap é o padrão do iNEXT() (argumento nboot); confira na versão que você usar.
Perguntas frequentes
Rarefação serve para comparar áreas com métodos de coleta diferentes?
Não. A rarefação só iguala a quantidade de esforço, não o tipo. Pitfall e guarda-chuva entomológico capturam faunas diferentes, e nenhuma conta corrige isso depois da coleta.
Rarefaço por indivíduos ou por amostras?
Se você tem só uma lista de indivíduos, só dá para rarefazer por indivíduos. Se tem amostras independentes, como armadilhas, prefira rarefazer por amostras, porque ela respeita a agregação das espécies e o seu desenho.
Posso rarefazer até um número menor que a menor amostra?
Pode, mas perde informação à toa, e as curvas tendem a convergir com amostras pequenas. O padrão é rarefazer até o tamanho da menor amostra, ou usar extrapolação para comparar num esforço maior.
Rarefação e extrapolação do iNEXT substituem a rarefação clássica?
Elas a ampliam. O iNEXT faz a mesma rarefação, acrescenta a extrapolação até o dobro da amostra e calcula intervalos de confiança, além de permitir comparar por cobertura amostral.
Para ir além
Leitura de base: o capítulo sobre rarefação do livro Análises Ecológicas no R, gratuito, e o artigo de Gotelli e Colwell (2001), que continua sendo a referência sobre as armadilhas na comparação de riqueza. A documentação do pacote está no CRAN do iNEXT.
Referências
- CHAO, A. et al. Rarefaction and extrapolation with Hill numbers: a framework for sampling and estimation in species diversity studies. Ecological Monographs, v. 84, n. 1, p. 45-67, 2014.
- CHAO, A.; JOST, L. Coverage-based rarefaction and extrapolation: standardizing samples by completeness rather than size. Ecology, v. 93, n. 12, p. 2533-2547, 2012.
- GOTELLI, N. J.; COLWELL, R. K. Quantifying biodiversity: procedures and pitfalls in the measurement and comparison of species richness. Ecology Letters, v. 4, n. 4, p. 379-391, 2001.
- HSIEH, T. C.; MA, K. H.; CHAO, A. iNEXT: an R package for rarefaction and extrapolation of species diversity (Hill numbers). Methods in Ecology and Evolution, v. 7, n. 12, p. 1451-1456, 2016.
- LANDE, R.; DEVRIES, P. J.; WALLA, T. R. When species accumulation curves intersect: implications for ranking diversity using small samples. Oikos, v. 89, n. 3, p. 601-605, 2000.
- MAGURRAN, A. E. Measuring biological diversity. Malden: Blackwell Publishing, 2004.
- SACKETT, T. E. et al. Response of macroarthropod assemblages to the loss of hemlock (Tsuga canadensis), a foundation species. Ecosphere, v. 2, art. 74, 2011.
Travou na comparação de riqueza com os seus dados?
Me mande a sua pergunta. A primeira conversa é sem custo.
Conversar no WhatsApp