A pergunta antes do código
Você coletou besouros com 30 armadilhas pitfall e registrou 64 espécies. A curva de acumulação ainda sobe. A pergunta que a sua dissertação precisa responder pode ser uma destas duas, e elas pedem coisas diferentes:
- Quantas espécies existem nessa área? Aqui o número observado subestima, e você precisa de um estimador.
- Esta área tem mais espécies do que aquela? Aqui o problema é comparar no mesmo esforço, e o caminho costuma ser rarefação ou extrapolação.
Este post trata da primeira. A ideia por trás de quase todos os estimadores é a mesma: espécies comuns aparecem em qualquer amostra e não dizem nada sobre o que falta. Quem informa são as raras. Se a sua amostra tem muitas espécies vistas uma vez só, ainda há muito por encontrar; se quase todas apareceram duas ou mais vezes, o inventário está perto de completo (Magurran, 2004, p. 87-88).
Antes de estimar, vale ter a curva de acumulação feita e lida. Ela é o primeiro passo, e tem um passo a passo próprio.
Qual estimador de riqueza usar?
A tabela resume o que Magurran (2004, cap. 3) reúne das comparações publicadas. A primeira coluna é o que você tem nas mãos.
| A sua situação | Use | Por quê |
|---|---|---|
| Contagem de indivíduos, indivíduos bem misturados entre amostras | Chao1 ou ACE | Usam espécies com 1 e 2 indivíduos (Chao1) ou com até 10 (ACE) |
| Presença em várias amostras (armadilhas, parcelas, redes) | Chao2, ICE, jackknife 1 ou 2 | Usam espécies que aparecem em 1 ou 2 amostras |
| Indivíduos agregados (muitas espécies em uma amostra só) | Chao2 ou ICE, não Chao1 nem ACE | A agregação faz os de abundância falharem (Chazdon et al., 1998, apud Magurran, 2004) |
| Poucas amostras | Chao2 ou jackknife 2 | Foram os mais precisos com poucas amostras em Colwell e Coddington (1994) |
| A estimativa ainda sobe com o esforço | Relate Chao como riqueza mínima | Estimador instável não estima o total (Longino et al., 2002, apud Magurran, 2004) |
| Amostras de habitats ou trechos de gradiente diferentes | Estime por habitat, não junte | Os estimadores de Chao supõem amostras homogêneas (Magurran, 2004, p. 89) |
Duas observações sobre a tabela. O ACE e o ICE são estimadores de cobertura: separam as espécies raras (até 10 indivíduos ou amostras) das abundantes e só usam as raras para estimar o que falta. E nenhuma linha diz “use o bootstrap”: nas comparações reunidas por Magurran (2004, p. 92), ele foi pior que o jackknife num estudo (Palmer, 1990, apud Magurran, 2004) e mais preciso que Chao e jackknife quando havia muitas espécies raras em outro (Poulin, 1998, apud Magurran, 2004). Não há um padrão que justifique escolhê-lo de saída.
O que cada estimador supõe
Chao1 soma à riqueza observada um termo que depende da razão entre singletons (F1, espécies com um indivíduo) e doubletons (F2, espécies com dois):
$$S_{\text{Chao1}} = S_{\text{obs}} + \frac{F_1^2}{2F_2}$$
Quanto mais singletons em relação a doubletons, maior a estimativa. Quando toda espécie tem pelo menos dois indivíduos, o termo zera e o inventário é considerado completo (Magurran, 2004, p. 87). Chao2 é a mesma conta com uniques (Q1, espécies que aparecem em uma amostra) e duplicates (Q2, em exatamente duas).
Jackknife 1 usa só os uniques; jackknife 2 usa uniques e duplicates. Os dois vieram de estudos de marcação e recaptura (Burnham; Overton, 1978, apud Magurran, 2004). O bootstrap usa a frequência de todas as espécies nas amostras.
Todos supõem que as amostras vêm de uma mesma comunidade e que cada espécie tem alguma chance de ser capturada pelo seu método. E todos dão, no fundo, uma estimativa mínima: Magurran (2004, p. 89) faz questão de repetir esse ponto.
Os estimadores lado a lado no R
O exemplo usa o mesmo dado real do post sobre curva de acumulação: árvores com pelo menos 10 cm de diâmetro em 50 parcelas de 1 ha em Barro Colorado, no Panamá (Condit et al., 2002), que vem no pacote vegan (licença GPL-2).
library(vegan)     # versão usada: 2.6-4
library(ggplot2)

data(BCI)                       # linhas = parcelas, colunas = espécies
abund <- colSums(BCI)           # indivíduos por espécie
ocorr <- colSums(BCI > 0)       # parcelas em que cada espécie aparece

c(singletons = sum(abund == 1), doubletons = sum(abund == 2),
  uniques    = sum(ocorr == 1), duplicates = sum(ocorr == 2))
singletons doubletons    uniques duplicates
        19         13         21         19
São 19 espécies com um único indivíduo e 21 que aparecem em uma única parcela. Guarde esses números: eles são quase tudo o que os estimadores usam.
Estimadores de incidência: specpool()
specpool(BCI)
    Species     chao chao.se  jack1 jack1.se    jack2     boot  boot.se  n
All     225 236.3732 6.54361 245.58 5.650522 247.8722 235.6862 3.468888 50
Leia a saída coluna por coluna:
Species= 225: a riqueza observada nas 50 parcelas.chao= 236,4,chao.se= 6,5: Chao2. Dá para refazer a conta: 225 + 21² / (2 × 19) × 49/50 = 236,4. O fator 49/50 é a correção para o número de amostras.jack1= 245,6 ejack2= 247,9: os jackknifes somam mais espécies que o Chao2, o que é comum.boot= 235,7: o bootstrap fica perto do Chao2 neste dado.n= 50: o número de amostras usado. Confira sempre; se aparecer outro número, a sua matriz não está no formato certo.
A faixa de estimativas vai de 236 a 248 espécies, ou de 11 a 23 espécies além das 225 observadas.
Estimadores de abundância: estimateR()
estimateR(abund)
     S.obs    S.chao1   se.chao1      S.ACE     se.ACE
225.000000 237.214286   7.434824 238.217659   7.118588
Chao1 dá 237,2 (erro-padrão 7,4) e ACE dá 238,2 (7,1), perto do Chao2. Se você fizer a conta com a fórmula acima, vai chegar a 238,9 em vez de 237,2. A diferença vem da versão com correção de viés que o estimateR() usa, descrita na ajuda da função (?estimateR). Diga no método qual versão usou.
Como checar se o estimador serviu
Um estimador “serviu” quando a estimativa para de depender do esforço. Três checagens dizem isso.
A estimativa estabiliza com o número de amostras?
A função poolaccum() recalcula os estimadores para 3, 4, 5… até 50 parcelas, sorteando a ordem das parcelas. Se a estimativa ainda sobe na última parcela, ela ainda depende do esforço.
set.seed(42)  # a ordem das parcelas é sorteada
pool <- poolaccum(BCI, permutations = 100)
res  <- summary(pool, display = c("S", "chao", "jack1", "jack2", "boot"))

# média de cada estimador para cada número de parcelas
estim <- data.frame(amostras = res$S[, 1], sapply(res, function(m) m[, 2]))
round(estim[estim$amostras %in% c(5, 10, 20, 30, 40, 50), ], 1)
   amostras     S  chao jack1 jack2  boot
3         5 159.8 184.8 194.4 206.3 176.7
8        10 182.9 206.3 212.4 222.7 197.4
18       20 202.0 225.8 227.8 238.5 214.4
28       30 212.8 236.2 238.1 248.8 224.8
38       40 220.0 237.0 243.2 249.7 231.4
48       50 225.0 236.4 245.6 247.9 235.7
longo <- stack(estim[, -1])
longo$amostras <- estim$amostras
longo$ind <- factor(longo$ind, levels = c("S", "chao", "jack1", "jack2", "boot"),
                    labels = c("Observada", "Chao2", "Jackknife 1", "Jackknife 2", "Bootstrap"))

ggplot(longo, aes(amostras, values, linetype = ind)) +
  geom_line(linewidth = 0.8) +
  labs(x = "Número de parcelas", y = "Riqueza (observada ou estimada)",
       linetype = NULL)
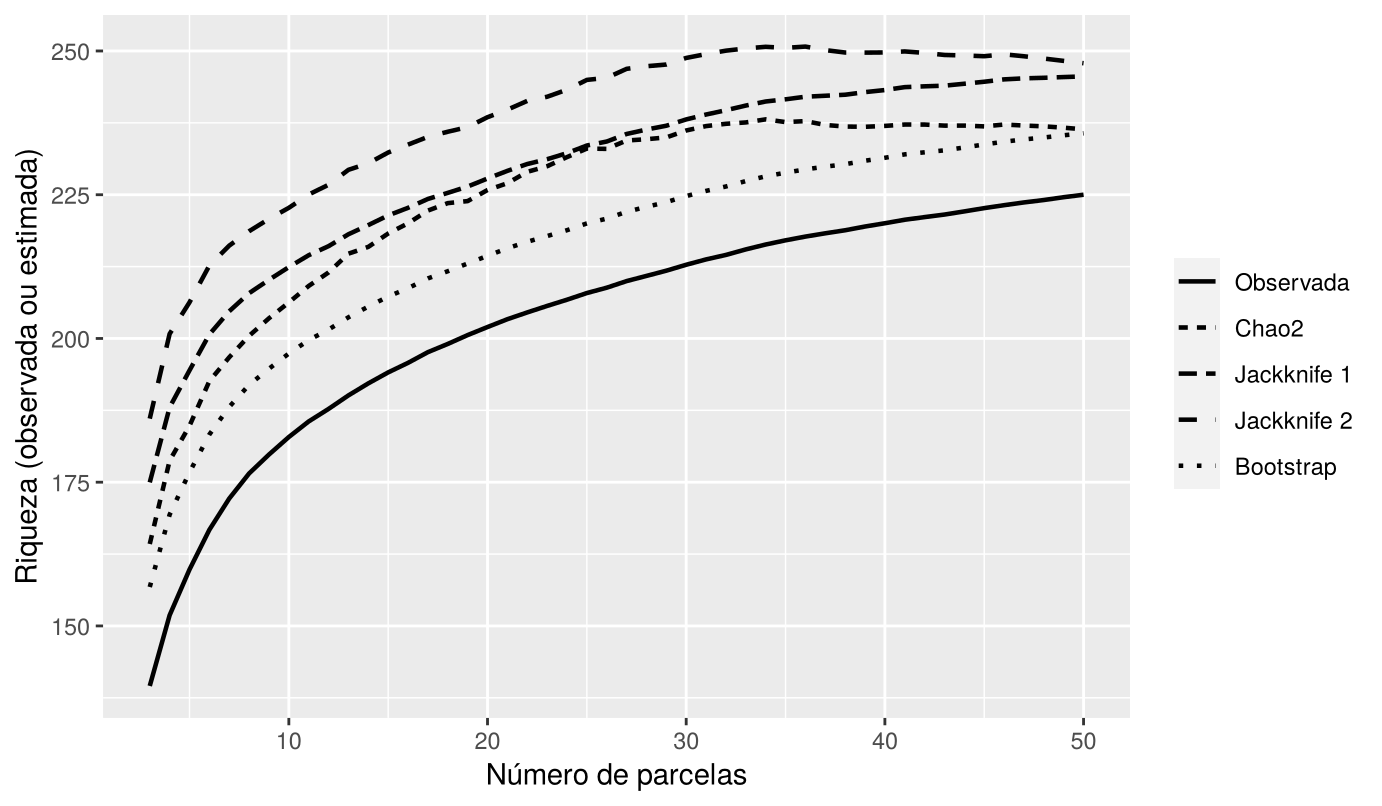
O Chao2 fica em torno de 236 a partir de 30 parcelas: de 30 para 50 parcelas, ele muda 0,2 espécie. O jackknife 2 também se acomoda perto de 248. O jackknife 1 e o bootstrap continuam subindo até a última parcela, e a riqueza observada também.
Os estimadores de abundância e de incidência concordam?
Compare Chao1 com Chao2 e ACE com ICE. Quando os indivíduos estão agregados, muitas espécies aparecem numa amostra só, mesmo com vários indivíduos. Aí os uniques passam muito dos singletons, e os estimadores de abundância falham (Magurran, 2004, p. 90). Em Barro Colorado, são 21 uniques contra 19 singletons, e Chao1 (237,2) e Chao2 (236,4) concordam. Num inventário de peixes de Trinidad que Magurran usa como exemplo, havia muito mais uniques que singletons, e Chao1 e ACE não diziam nada além da riqueza observada.
As metades dão a mesma resposta?
Magurran (2004, p. 94) sugere dividir as amostras ao acaso em duas metades e estimar cada uma. Se as metades concordam com o total, você tem dado suficiente. Uma divisão só depende da sorte; repita 100 vezes.
set.seed(7)
metades <- replicate(100, {
  m <- sample(nrow(BCI), 25)           # sorteia 25 das 50 parcelas
  c(specpool(BCI[m, ])$chao, specpool(BCI[-m, ])$chao)
})
round(quantile(metades, c(0.025, 0.5, 0.975)), 1)
 2.5%   50% 97.5%
211.8 230.7 264.3
mean(metades < 225) # metades que estimam menos que o observado com 50
[1] 0.3
Com 25 parcelas, o Chao2 tem mediana de 230,7, abaixo dos 236,4 do total, e varia de 211,8 a 264,3 entre as divisões. Em 30% das metades, a estimativa fica abaixo das 225 espécies que as 50 parcelas de fato registraram. Ou seja: com metade do esforço, o estimador ainda não tinha chegado ao total.
A armadilha: tratar a estimativa como a riqueza verdadeira
O sintoma. O texto diz “a riqueza estimada da área é de 246 espécies (jackknife 1)”, e a figura do estimador, se existe, mostra a linha ainda subindo.
Por que é um problema. Um estimador que ainda sobe está medindo o seu esforço, não a comunidade. Veja a tabela do poolaccum(): com 20 parcelas, o bootstrap estimava 214,4 espécies, menos do que as 225 que você observa com 50. Se a coleta tivesse parado em 20 parcelas, o “total estimado” seria menor do que a riqueza realmente presente. O mesmo vale para comparações: duas áreas amostradas com esforços diferentes terão estimativas diferentes mesmo que tenham a mesma riqueza.
A correção. Mostre a curva do estimador contra o esforço e escolha um que tenha estabilizado. Se nenhum estabilizou, escreva que a estimativa é uma riqueza mínima; Longino et al. (2002, apud Magurran, 2004, p. 94) defendem os estimadores de Chao nesse papel. E nunca estime juntando habitats diferentes: o resultado é a riqueza de uma comunidade que não existe.
Se você está com estimativas que não batem entre si e não sabe qual relatar, é exatamente esse tipo de dúvida que resolvemos numa consultoria.
Erros comuns na escolha
- Escolher o estimador que dá o maior número. A escolha vem do tipo de dado e da estabilidade, e é feita antes de olhar o resultado.
- Usar Chao1 com dado de armadilhas somadas. Somar as armadilhas transforma incidência em abundância e esconde a agregação. Se você tem amostras, use os estimadores de incidência.
- Relatar o número sem o erro-padrão. Sem a incerteza, o leitor não sabe se 236 e 248 são diferentes.
- Esquecer o limite do método. O estimador só estima o que a sua técnica de coleta consegue pegar. Pitfall não estima a fauna de copa (Magurran, 2004, p. 137).
Até onde os estimadores vão
Os estimadores funcionam bem quando a comunidade é razoavelmente homogênea e o esforço já pegou boa parte das espécies. Eles falham quando a raridade é extrema: em formigas de La Selva, na Costa Rica, nenhum dos três estimadores testados chegou a uma assíntota estável, mesmo com quase 2.000 amostras (Longino et al., 2002, apud Magurran, 2004, p. 93). Em comunidades muito ricas e pouco amostradas, o melhor que você consegue é um mínimo, e isso já é informação útil.
Como escrever o estimador de riqueza na dissertação
specpool, pacote vegan [versão], R [versão]). Avaliamos a estabilidade das estimativas recalculando-as para número crescente de amostras, com 100 ordens aleatórias (função poolaccum).
Se o seu estimador não estabilizou, troque a última frase por: “Como as estimativas ainda aumentavam com o esforço, consideramos o valor de Chao2 uma estimativa mínima da riqueza”.
Perguntas frequentes
Qual é o melhor estimador de riqueza?
Não existe um vencedor para todo dado. Nas comparações revisadas por Magurran (2004), os estimadores de Chao e os jackknifes ficaram entre os menos enviesados, e Chao2 e jackknife 2 funcionaram bem com poucas amostras. Escolha pelo tipo de dado e confira a estabilidade.
Posso usar estimadores de riqueza com dados de presença e ausência?
Pode, e é o caso mais comum. Chao2, ICE, jackknife 1 e 2 e bootstrap usam só em quantas amostras cada espécie apareceu. Chao1 e ACE é que precisam da contagem de indivíduos.
O estimador pode dar menos espécies do que eu observei?
No mesmo conjunto de amostras, não: todos somam algo à riqueza observada. Mas uma estimativa feita com poucas amostras pode ficar abaixo da riqueza que você observaria coletando mais. Por isso a estimativa é um mínimo.
Posso comparar a riqueza estimada de duas áreas com teste t?
Com uma estimativa por área, não há réplica para o teste. Compare os intervalos de confiança e, se você tem várias áreas por tratamento, estime por área e use as estimativas como resposta num modelo.
Para ir além
Leitura de base: o capítulo sobre estimadores de riqueza do livro Análises Ecológicas no R, gratuito, e o capítulo 3 de Magurran (2004), que compara os estimadores em dados de peixes, besouros e formigas. O artigo de Colwell e Coddington (1994) continua sendo a melhor introdução à lógica da extrapolação.
Referências
- CHAO, A. Nonparametric estimation of the number of classes in a population. Scandinavian Journal of Statistics, v. 11, n. 4, p. 265-270, 1984.
- COLWELL, R. K.; CODDINGTON, J. A. Estimating terrestrial biodiversity through extrapolation. Philosophical Transactions of the Royal Society of London B, v. 345, n. 1311, p. 101-118, 1994.
- CONDIT, R. et al. Beta-diversity in tropical forest trees. Science, v. 295, n. 5555, p. 666-669, 2002.
- MAGURRAN, A. E. Measuring biological diversity. Malden: Blackwell Publishing, 2004.
- OKSANEN, J. et al. vegan: community ecology package. R package version 2.6-4, 2022. Disponível em: https://CRAN.R-project.org/package=vegan. Acesso em: [dia] [mês abreviado]. [ano].
Travou na estimativa de riqueza com os seus dados?
Me mande a sua pergunta. A primeira conversa é sem custo.
Conversar no WhatsApp