A pergunta antes do código
Imagine que você instalou 50 parcelas numa floresta e identificou todas as árvores. Na qualificação, alguém da banca pergunta: “o seu esforço foi suficiente?”. É para essa pergunta que a curva de acumulação existe.
Repare no que ela responde e no que não responde. Ela responde: se eu tivesse coletado mais, a minha lista de espécies teria mudado muito? Ela não responde quantas espécies existem no lugar. Para isso existem os estimadores de riqueza, que têm post próprio.
Também vale separar duas curvas que costumam ser confundidas. Magurran (2004, p. 79) lembra que só conta como curva de acumulação aquela que soma porções cada vez maiores do mesmo lugar. Uma curva que junta ilhas, fragmentos ou habitats diferentes é uma relação espécie-área, e responde outra pergunta.
O dado: 50 parcelas em Barro Colorado
O exemplo usa um dado real que já vem no pacote vegan: a contagem de árvores com pelo menos 10 cm de diâmetro em 50 parcelas de 1 ha na Ilha de Barro Colorado, no Panamá (Condit et al., 2002), distribuída com o vegan sob licença GPL-2. É floresta tropical, com muitas espécies raras, e por isso a curva tem o comportamento que você vai encontrar com insetos, aranhas e aves de mata.
library(vegan)     # versão usada: 2.6-4
library(iNEXT)     # versão usada: 3.0.2
library(ggplot2)

data(BCI)          # linhas = parcelas, colunas = espécies
dim(BCI)
[1] 50 225
sum(BCI) # total de árvores
[1] 21457
BCI[1:3, 1:3]
  Abarema.macradenia Vachellia.melanoceras Acalypha.diversifolia
1                  0                     0                     0
2                  0                     0                     0
3                  0                     0                     0
São 50 parcelas, 225 espécies e 21.457 árvores. O formato é o que o vegan espera: uma linha por unidade amostral e uma coluna por espécie, com a contagem em cada célula. Se o seu dado está em formato longo (uma linha por registro), tidyr::pivot_wider() faz a conversão.
A curva na ordem da coleta
Antes de embaralhar, veja a curva na ordem em que as parcelas estão na planilha. É a chamada curva do coletor.
coleta <- specaccum(BCI, method = "collector")
coleta$richness[c(1, 2, 5, 10)]
  1   2   5  10
 93 113 152 170
A primeira parcela tem 93 espécies; com dez parcelas, a lista chega a 170. O problema é que essa forma depende da ordem. Uma parcela muito rica no começo puxa a curva para cima; se ela entrar no fim, a curva sobe tarde (Magurran, 2004, p. 79). Como a ordem da planilha é arbitrária, a curva também é.
Ajustar: specaccum() com ordem aleatória
A solução é sortear a ordem das parcelas muitas vezes e tirar a média. Colwell e Coddington (1994) usaram 100 sorteios, que é o padrão do vegan.
set.seed(42)  # a ordem das parcelas é sorteada
acum <- specaccum(BCI, method = "random", permutations = 100)
curvas <- data.frame(
  parcelas  = acum$sites,
  aleatoria = acum$richness,
  dp        = acum$sd,
  coleta    = coleta$richness
)

ggplot(curvas, aes(parcelas)) +
  geom_ribbon(aes(ymin = aleatoria - 2 * dp, ymax = aleatoria + 2 * dp),
              alpha = 0.3) +
  geom_line(aes(y = aleatoria), linewidth = 1) +
  geom_line(aes(y = coleta), linetype = "dashed") +
  labs(x = "Número de parcelas (1 ha cada)", y = "Espécies acumuladas")
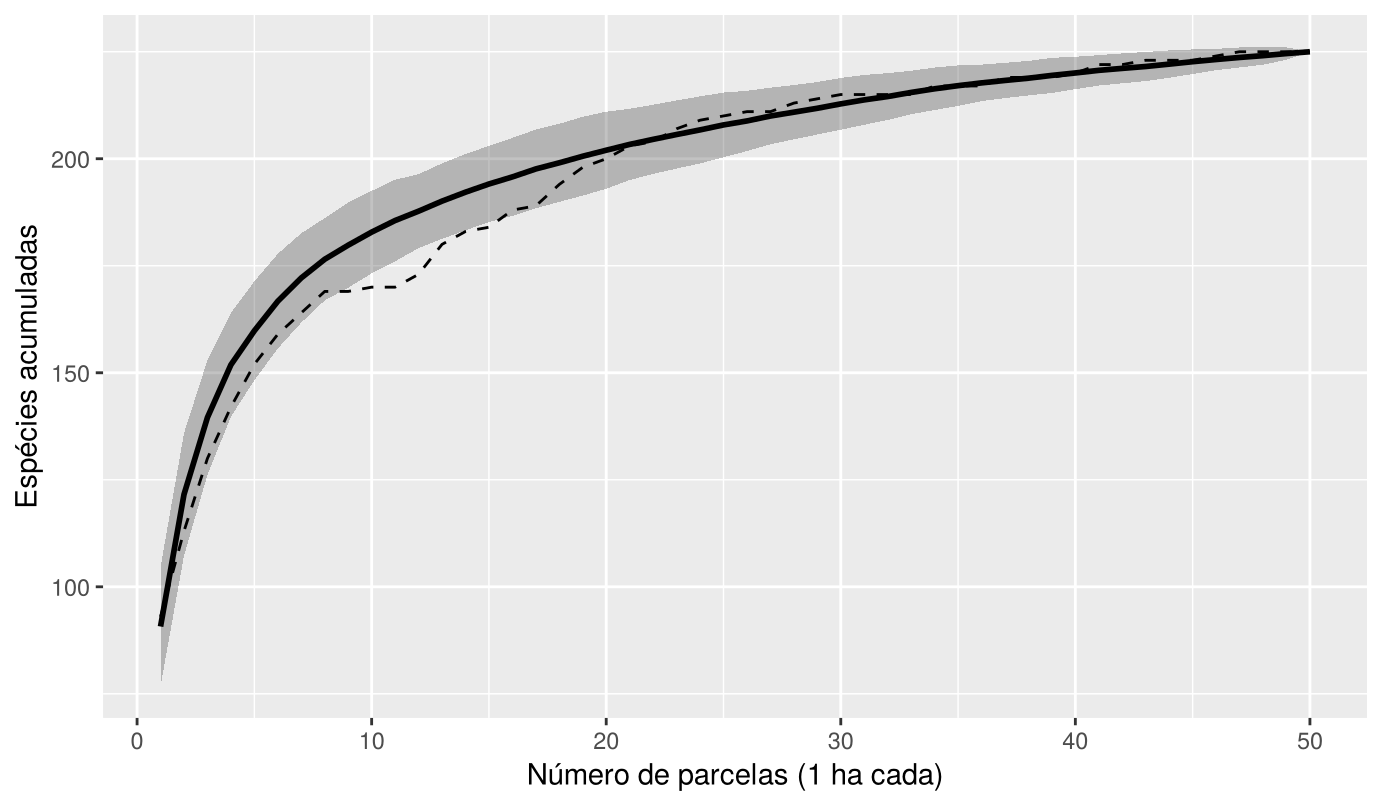
A curva sobe rápido e depois desacelera. Desacelerar não é a mesma coisa que parar, e é isso que os próximos passos verificam.
Como ler a saída, linha por linha
O objeto acum guarda a riqueza média e o desvio-padrão para cada número de parcelas. Uma tabela com alguns pontos é mais fácil de ler do que o print() inteiro.
tab <- data.frame(parcelas = acum$sites, riqueza = acum$richness, dp = acum$sd)
round(tab[c(1, 2, 5, 10, 20, 30, 40, 45, 50), ], 1)
   parcelas riqueza  dp
1         1    90.7 6.9
2         2   121.6 7.2
5         5   159.8 5.8
10       10   182.9 4.8
20       20   202.0 4.5
30       30   212.8 3.0
40       40   220.0 1.9
45       45   222.7 1.4
50       50   225.0 0.0
- Linha
1: riqueza 90,7, dp 6,9. Uma parcela sozinha tem, em média, 91 espécies. O desvio de 6,9 mostra o quanto as parcelas variam entre si. - Linha
10: riqueza 182,9. Com 20% do esforço, você já tem 81% das 225 espécies. É o trecho em que entram as espécies comuns. - Linhas
40a50: de 220,0 para 225,0. Dez hectares a mais renderam cinco espécies, cerca de meia espécie por parcela. A curva desacelerou, mas não parou. - Linha
50: dp 0,0. Esse zero não é precisão. Todas as ordens sorteadas terminam com as 50 parcelas, então todas dão 225. Volto a esse ponto na armadilha.
Checar: a curva chegou na assíntota?
Olhar a figura e dizer “estabilizou” é a forma mais comum de errar aqui. Use três critérios com número.
Quanto a curva ainda sobe no fim?
acum$richness[50] - acum$richness[40]
[1] 4.96
As últimas 10 parcelas acrescentaram 4,96 espécies, ou 2,2% da lista. Isso é pouco para a lista das espécies comuns e muito se a sua pergunta é sobre as raras.
A curva é assintótica ou logarítmica?
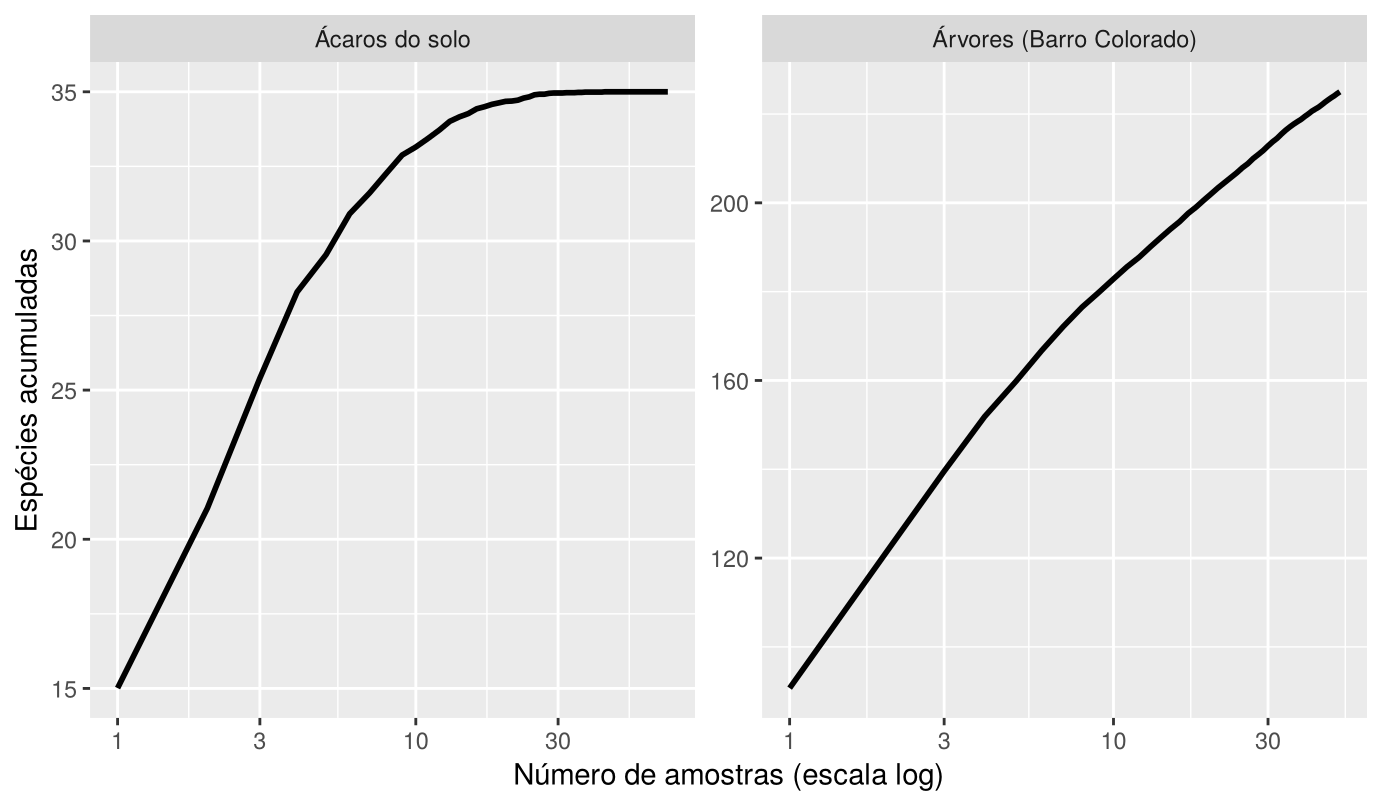
Num eixo linear, quase toda curva parece estar achatando. Longino et al. (2002, apud Magurran, 2004, p. 79) recomendam o eixo x em escala log: uma curva que continua subindo em linha reta nessa escala é logarítmica, ou seja, não tem teto à vista.
Para comparar, o gráfico abaixo inclui um segundo dado real do vegan: ácaros oribatídeos em 70 amostras de solo (Borcard; Legendre, 1994), também distribuído com o pacote.
data(mite)
set.seed(42)
acum_mite <- specaccum(mite, method = "random", permutations = 100)

duas <- rbind(
  data.frame(grupo = "Árvores (Barro Colorado)", amostras = acum$sites,
             riqueza = acum$richness),
  data.frame(grupo = "Ácaros do solo", amostras = acum_mite$sites,
             riqueza = acum_mite$richness)
)

ggplot(duas, aes(amostras, riqueza)) +
  geom_line(linewidth = 1) +
  scale_x_log10() +
  facet_wrap(~ grupo, scales = "free") +
  labs(x = "Número de amostras (escala log)", y = "Espécies acumuladas")
acum_mite$richness[c(10, 20)] # ácaros: riqueza média com 10 e 20 amostras
[1] 33.15 34.68
Os ácaros chegam a um teto: com 10 amostras, a média é 33,1 espécies; com 20, já é 34,7 das 35. As árvores, não. Na escala log, a curva de Barro Colorado segue subindo até a última parcela.
Quantas espécies apareceram uma vez só?
Colwell e Coddington (1994) propõem uma regra de parada simples: o inventário pode ser tratado como completo quando toda espécie aparece em pelo menos duas amostras.
ocorrencias <- colSums(BCI > 0)        # em quantas parcelas cada espécie aparece
sum(ocorrencias == 1)                  # espécies em uma parcela só
[1] 21
sum(ocorrencias == 2) # em exatamente duas
[1] 19
min(colSums(mite > 0)) # menor número de amostras, nos ácaros
[1] 8
Em Barro Colorado, 21 espécies aparecem em uma parcela só e 19 em exatamente duas. Nos ácaros, a espécie mais rara aparece em 8 amostras. A regra confirma o que o gráfico mostrou.
A mesma informação dá uma medida direta de completude, a cobertura amostral (sample coverage) de Chao e Jost (2012), que o iNEXT calcula:
DataInfo(list(BCI = c(nrow(BCI), colSums(BCI > 0))), datatype = "incidence_freq")
  Assemblage  T    U S.obs     SC Q1 Q2 Q3 Q4 Q5 Q6 Q7 Q8 Q9 Q10
1        BCI 50 4539   225 0.9955 21 19 10  5  6  3  5  7  6   5
A coluna SC vale 0,9955. A leitura: as espécies que você ainda não registrou respondem por cerca de 0,5% das ocorrências esperadas numa parcela nova. A lista das espécies comuns está completa; as raras ainda estão chegando.
Do número à frase
Juntando os três critérios, a frase honesta para este dado é algo como:
A curva de acumulação desacelerou, mas não atingiu uma assíntota: as últimas 10 parcelas acrescentaram cinco espécies (2,2% do total), e 21 espécies foram registradas em uma única parcela. A cobertura amostral estimada foi de 99,5%.
Repare que a frase não diz “o esforço foi suficiente”. Suficiente depende da pergunta. Para comparar a composição das espécies comuns entre áreas, 50 parcelas sobram. Para dizer quantas espécies existem na floresta, não bastam, e aí o caminho é um estimador de riqueza.
A armadilha: a faixa que fecha no fim
Esse é o erro que eu mais vejo em figura de dissertação, e a banca atenta pega.
O sintoma. A faixa de incerteza da curva vai se estreitando e chega a zero na última amostra, como na primeira figura. O texto diz: “a curva estabilizou, como mostra a redução do desvio-padrão”.
Por que está errado. O desvio que o specaccum(method = "random") devolve mede o quanto a riqueza varia entre ordens sorteadas das mesmas amostras. Na última amostra, todas as ordens contêm tudo, e o desvio é zero por construção. Ele não diz nada sobre o que aconteceria com mais coleta. Em Barro Colorado, a faixa fecha em 225 espécies, mas a curva ainda ganhava meia espécie por parcela.
A correção. Para julgar a suficiência, use o ganho no trecho final, o eixo log, a contagem de espécies em uma amostra só e a cobertura. Se você quer incerteza sobre o que existe além da sua coleta, use extrapolação com intervalos que não fecham por construção, como a do iNEXT (Chao et al., 2014), ou um estimador de riqueza.
Duas variações do mesmo erro aparecem com frequência. A primeira é juntar parcelas de habitats diferentes numa curva só e chamar o resultado de suficiência; Magurran (2004, p. 80) lembra que a extrapolação só faz sentido em habitat razoavelmente homogêneo. A segunda é comparar dois locais pela altura das curvas: elas podem se cruzar, e o local “mais rico” muda conforme o esforço (Lande; DeVries; Walla, 2000). Esse caso tem um post só para ele: como comparar riqueza com esforço diferente.
Se a sua curva tem esse jeito e você não sabe o que escrever sobre suficiência, é exatamente o tipo de dúvida que resolvemos numa mentoria, com o seu dado na tela.
Onde a curva não ajuda
A curva só enxerga o que o seu método captura. Uma armadilha pitfall não amostra a fauna de copa, e uma curva perfeitamente estável de pitfall diz que você esgotou o que o pitfall pega, não a comunidade. Magurran (2004, p. 137) chama isso de efeito de borda metodológico: espécies mal amostradas por uma técnica parecem raras ou ausentes.
A curva também muda com a unidade do eixo x. Curvas por amostra ficam abaixo das curvas por indivíduo, porque as espécies se agregam no espaço (Gotelli; Colwell, 2001). Use a unidade que é independente no seu desenho, quase sempre a armadilha ou a parcela, e diga qual usou.
Como escrever a curva de acumulação na dissertação
specaccum, pacote vegan [versão], R [versão]). Avaliamos a aproximação da assíntota pelo número de espécies acrescentadas nas últimas [10] amostras, pelo número de espécies registradas em uma única amostra e pela cobertura amostral baseada em incidência (Chao; Jost, 2012), calculada com o pacote iNEXT [versão].
Se a sua curva atingiu a assíntota, troque a segunda frase dos resultados e mostre o critério: “todas as espécies ocorreram em pelo menos [duas] amostras”.
Perguntas frequentes
Quantas permutações usar na curva de acumulação?
Cem permutações é o valor mais usado, e foi o de Colwell e Coddington (1994). O teste prático é rodar de novo com outra semente: se a curva média muda na primeira casa decimal, aumente o número de permutações.
Qual a diferença entre curva de acumulação e curva de rarefação?
As duas são parentes. A curva de acumulação é lida da esquerda para a direita e pergunta o que acontece se você amostrar mais. A rarefação é lida da direita para a esquerda e pergunta quantas espécies você teria com menos esforço, para comparar locais no mesmo esforço.
A curva precisa estabilizar para eu publicar?
Não. Em comunidades ricas, como insetos tropicais, a curva quase nunca estabiliza. O que a banca e o revisor esperam é que você mostre o quanto ela ainda sobe e não chame de suficiente o que não é.
No eixo x vão as amostras ou os indivíduos?
Use a sua unidade amostral: armadilha, parcela, transecto. Curvas por amostra ficam abaixo das curvas por indivíduo, porque as espécies se agregam no espaço, e é a amostra que é independente no seu desenho.
Para ir além
Leitura de base: os capítulos sobre rarefação e estimadores de riqueza do livro Análises Ecológicas no R, gratuito, e o capítulo 3 de Magurran (2004), que compara os métodos com dados reais. A documentação da função está no manual do vegan no CRAN.
Referências
- BORCARD, D.; LEGENDRE, P. Environmental control and spatial structure in ecological communities: an example using oribatid mites (Acari, Oribatei). Environmental and Ecological Statistics, v. 1, p. 37-61, 1994.
- CHAO, A. et al. Rarefaction and extrapolation with Hill numbers: a framework for sampling and estimation in species diversity studies. Ecological Monographs, v. 84, n. 1, p. 45-67, 2014.
- CHAO, A.; JOST, L. Coverage-based rarefaction and extrapolation: standardizing samples by completeness rather than size. Ecology, v. 93, n. 12, p. 2533-2547, 2012.
- COLWELL, R. K.; CODDINGTON, J. A. Estimating terrestrial biodiversity through extrapolation. Philosophical Transactions of the Royal Society of London B, v. 345, n. 1311, p. 101-118, 1994.
- CONDIT, R. et al. Beta-diversity in tropical forest trees. Science, v. 295, n. 5555, p. 666-669, 2002.
- GOTELLI, N. J.; COLWELL, R. K. Quantifying biodiversity: procedures and pitfalls in the measurement and comparison of species richness. Ecology Letters, v. 4, n. 4, p. 379-391, 2001.
- LANDE, R.; DEVRIES, P. J.; WALLA, T. R. When species accumulation curves intersect: implications for ranking diversity using small samples. Oikos, v. 89, n. 3, p. 601-605, 2000.
- MAGURRAN, A. E. Measuring biological diversity. Malden: Blackwell Publishing, 2004.
Quer aprender a montar e ler essa curva com os seus dados?
Me mande a sua pergunta. A primeira conversa é sem custo.
Conversar no WhatsApp