A pergunta antes do código
O pedido mais comum que eu recebo sobre diversidade é: “qual índice eu uso?”. A pergunta certa vem antes: diversidade de quê? Você quer saber quantas espécies existem, mesmo as que aparecem uma vez? Quer saber se a comunidade é dominada por poucas espécies? Ou quer um número que pese as duas coisas?
Magurran (2004, p. 100) lembra que nenhum índice resolve isso sozinho: todo índice dá mais peso à riqueza ou à equabilidade, e por isso não existe uma medida única de diversidade. O primeiro conselho do quadro dela sobre como escolher um índice é resistir à tentação de calcular todos e ficar com o que dá a resposta mais bonita (Magurran, 2004, p. 101). A escolha vem da pergunta, antes de ver os números.
Se a sua pergunta é só sobre número de espécies, este post não é o seu ponto de partida: comece pela comparação de riqueza com esforço igual.
Shannon ou Simpson: qual usar?
| A sua pergunta | Use | Por quê |
|---|---|---|
| Quantas espécies, com as raras valendo o mesmo que as comuns | Riqueza (Hill de ordem 0) | É a medida mais intuitiva e a mais sensível ao esforço |
| Diversidade com peso proporcional à abundância | exp(H’), Hill de ordem 1 | Transforma Shannon num número de espécies, que dá para comparar |
| Dominância das espécies comuns, amostras pequenas ou de tamanhos diferentes | 1/D, Hill de ordem 2 | Estabiliza com amostras menores e ordena as comunidades de forma consistente (Lande; DeVries; Walla, 2000) |
| As medidas discordam sobre qual área é mais diversa | Perfil de Hill (ordens 0 a 2 ou mais) | Mostra em que parte da comunidade está a diferença |
| Só a importância da espécie mais comum | Berger-Parker | É a proporção da espécie mais abundante, fácil de ler (Magurran, 2004, p. 117) |
A coluna do meio usa os números de Hill (Hill, 1973), que reúnem os índices clássicos numa mesma escala: o número efetivo de espécies. A ordem 0 é a riqueza; a ordem 1 é exp(H’); a ordem 2 é o inverso de Simpson (Magurran, 2004, p. 148-149). Quanto maior a ordem, menos peso as espécies raras recebem.
O que cada índice supõe
Shannon (H′ = − ∑piln pi, em que pi é a proporção de indivíduos da espécie i) supõe que os indivíduos foram amostrados ao acaso de uma comunidade muito grande e que todas as espécies estão na amostra (Magurran, 2004, p. 106-107). A segunda suposição quase nunca vale, e por isso não existe estimador sem viés de Shannon (Lande, 1996, apud Magurran, 2004, p. 107). Na prática, H’ fica entre 1,5 e 3,5 e raramente passa de 4, o que torna difícil dizer se 2,35 e 2,47 são diferentes (Magurran, 2004, p. 107-108).
Simpson (D = ∑pi2) é a probabilidade de dois indivíduos sorteados serem da mesma espécie. Como D cresce quando a diversidade cai, ele é relatado como 1 − D ou 1/D. É pesado pelas espécies mais abundantes e menos sensível à riqueza (Magurran, 2004, p. 115).
Aqui as fontes discordam, e vale você saber. Magurran (2004, p. 101) é dura com Shannon: diz que o seu uso precisa de justificativa muito mais forte e que passar para exp(H’) não resolve os problemas de fundo. Jost (2006) e Chao et al. (2014) defendem o oposto: em forma de número efetivo, Shannon é uma das três medidas que valem a pena relatar. O critério que eu uso para conciliar: se você usar Shannon, use exp(H’), sempre ao lado da riqueza e de 1/D, e nunca como medida única.
Os índices lado a lado no R
O exemplo usa duas parcelas reais de 1 ha de floresta tropical na Ilha de Barro Colorado, no Panamá, com todas as árvores de pelo menos 10 cm de diâmetro (Condit et al., 2002). O dado vem no pacote vegan (licença GPL-2). Escolhi as parcelas 1 e 19 porque elas têm quase o mesmo número de árvores e mostram bem o problema.
library(vegan)     # versão usada: 2.6-4
library(iNEXT)     # versão usada: 3.0.2
library(ggplot2)

data(BCI)
parcelas <- BCI[c(1, 19), ]
rownames(parcelas) <- c("P1", "P19")

indices <- data.frame(
  S            = specnumber(parcelas),
  N            = rowSums(parcelas),
  shannon      = diversity(parcelas, "shannon"),      # log natural
  exp_shannon  = exp(diversity(parcelas, "shannon")),
  gini_simpson = diversity(parcelas, "simpson"),      # 1 - D
  inv_simpson  = diversity(parcelas, "invsimpson")    # 1 / D
)
round(indices, 3)
      S   N shannon exp_shannon gini_simpson inv_simpson
P1   93 448   4.018      55.613        0.975      39.416
P19 109 433   4.013      55.318        0.966      29.055
Leia a saída coluna por coluna:
S: 93 contra 109. A P19 tem 16 espécies a mais, com quase o mesmo número de árvores (N: 448 e 433).shannon: 4,018 contra 4,013. Na terceira casa decimal. Por Shannon, as duas parcelas são iguais.exp_shannon: 55,6 contra 55,3. Em número efetivo, continua empatado: as duas equivalem a uma floresta com cerca de 55 espécies igualmente comuns.gini_simpson: 0,975 contra 0,966. Parece outro empate. Essa forma é uma probabilidade e fica espremida perto de 1 em comunidades ricas.inv_simpson: 39,4 contra 29,1. Agora a P1 é 36% mais diversa. É o mesmo índice de Simpson da coluna anterior, em outra escala.
Então qual é mais diversa? Depende da pergunta, e o próximo passo mostra por quê.
Como checar qual índice serviu
Onde está a diferença: o perfil de Hill
renyi(parcelas, scales = c(0, 0.5, 1, 2, 4, Inf), hill = TRUE)
      0      0.5        1        2        4       Inf
P1   93 71.17027 55.61270 39.41555 29.13055 17.920000
P19 109 79.58424 55.31774 29.05455 16.62593  9.840909
c(dominancia = apply(parcelas, 1, function(x) max(x) / sum(x)),   # Berger-Parker
  singletons = rowSums(parcelas == 1))
 dominancia.P1 dominancia.P19  singletons.P1 singletons.P19
    0.05580357     0.10161663    31.00000000    48.00000000
ordens <- seq(0, 4, by = 0.1)
perfil <- renyi(parcelas, scales = ordens, hill = TRUE)
perfil_longo <- data.frame(
  ordem    = rep(ordens, each = 2),
  efetivo  = as.vector(as.matrix(perfil)),
  parcela  = rep(rownames(parcelas), times = length(ordens))
)
ggplot(perfil_longo, aes(ordem, efetivo, linetype = parcela)) +
  geom_line(linewidth = 0.9) +
  labs(x = "Ordem q (peso dado às espécies comuns)",
       y = "Número efetivo de espécies", linetype = "Parcela")
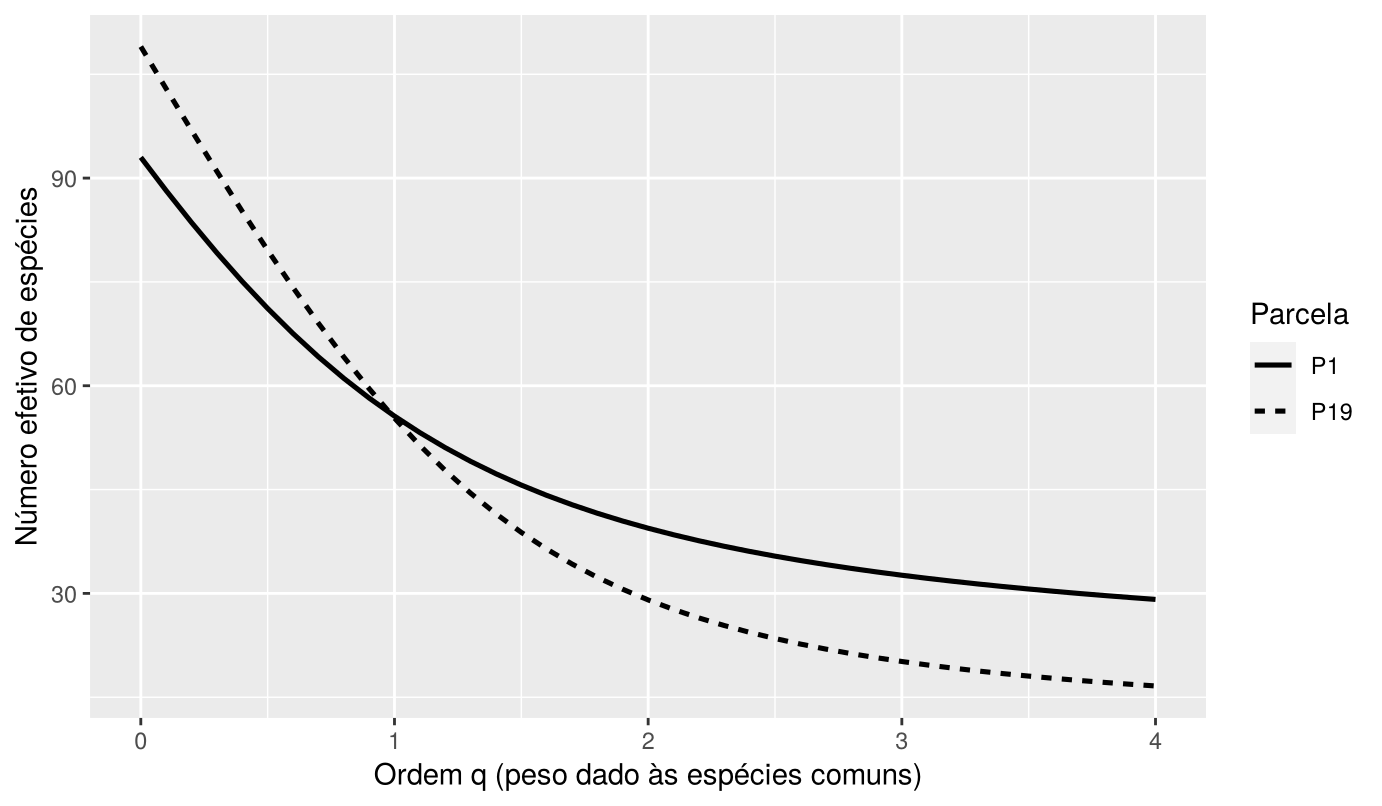
O perfil conta a história inteira. Na ordem 0, a P19 ganha: 109 contra 93 espécies. Na ordem 1, as duas empatam em 55. Da ordem 2 em diante, a P1 ganha, e a distância cresce: na ordem 4, são 29,1 contra 16,6 espécies efetivas.
A explicação está nas duas últimas linhas. A P19 tem 48 espécies com uma única árvore (a P1 tem 31), e por isso é mais rica. Mas a espécie mais comum da P19, Trichilia tuberculata, tem 10,2% das árvores; na P1, a mais comum tem 5,6%. A P19 tem mais espécies raras e mais dominância. Shannon soma os dois efeitos, que se cancelam, e devolve um empate.
Quando os perfis se cruzam, não existe resposta única para “qual é mais diversa”, e Magurran (2004, p. 149-150) diz o mesmo: diferentes ordens podem ordenar as comunidades de formas diferentes. Relate o perfil, ou ao menos as ordens 0, 1 e 2, e diga qual delas responde à sua pergunta.
No mesmo esforço, a diferença continua?
As parcelas têm 448 e 433 árvores. A diferença é pequena, mas a riqueza é sensível até a ela. O estimateD() do iNEXT calcula as três ordens no mesmo número de indivíduos, com intervalo de confiança por bootstrap (Chao et al., 2014).
lista <- lapply(seq_len(nrow(parcelas)), function(i) {
  x <- unlist(parcelas[i, ]); x[x > 0]       # o iNEXT quer só as espécies presentes
})
names(lista) <- rownames(parcelas)

set.seed(5)  # os intervalos vêm de bootstrap
estimateD(lista, q = c(0, 1, 2), datatype = "abundance", base = "size", level = 433)
  Assemblage   m      Method Order.q        SC        qD   qD.LCL    qD.UCL
1         P1 433 Rarefaction       0 0.9282304  91.94290 84.56159  99.32420
2         P1 433 Rarefaction       1 0.9282304  55.33472 50.31944  60.35000
3         P1 433 Rarefaction       2 0.9282304  39.29856 35.15022  43.44689
4        P19 433    Observed       0 0.8893056 109.00000 97.90506 120.09494
5        P19 433    Observed       1 0.8893056  55.31774 49.58056  61.05492
6        P19 433    Observed       2 0.8893056  29.05455 24.80060  33.30849
Com 433 árvores nas duas, a P1 teria 91,9 espécies (intervalo de 84,6 a 99,3) contra 109 da P19 (97,9 a 120,1). Na ordem 1, 55,3 nas duas. Na ordem 2, 39,3 (35,2 a 43,4) contra 29,1 (24,8 a 33,3): os intervalos não se sobrepõem. O padrão se mantém no mesmo esforço.
Quanto cada índice depende do tamanho da amostra?
Esta é a checagem que mais pesa na escolha. O código sorteia subamostras da P1, de 25 a 448 árvores, e calcula as três ordens em cada uma.
set.seed(20)
p1 <- unlist(parcelas["P1", ])
tamanhos <- c(25, 50, 100, 200, 300, 448)

sens <- t(sapply(tamanhos, function(n) {
  r <- replicate(200, {                      # 200 subamostras de cada tamanho
    y <- rrarefy(p1, n)
    c(q0 = sum(y > 0), q1 = exp(diversity(y)), q2 = diversity(y, "invsimpson"))
  })
  rowMeans(r)
}))
rownames(sens) <- tamanhos
round(100 * sweep(sens, 2, sens[nrow(sens), ], "/"))   # % do valor com 448 árvores
     q0  q1  q2
25   21  32  41
50   35  50  60
100  52  68  77
200  73  85  90
300  87  94  96
448 100 100 100
Com 100 árvores, a riqueza capta 52% do valor da parcela inteira; exp(H’), 68%; 1/D, 77%. Com 200 árvores, 73%, 85% e 90%. O inverso de Simpson estabiliza primeiro, como Magurran (2004, p. 133-134) relata para florestas na Índia e na Malásia (Gimaret-Carpentier et al., 1998, apud Magurran, 2004). Se as suas amostras têm tamanhos diferentes e você não pode rarefazer, 1/D é a medida que menos engana.
A armadilha: concluir “diversidade igual” pelo Shannon
O sintoma. A tabela de resultados tem H’ = 4,02 e 4,01, ou 1 − D = 0,975 e 0,966, e o texto diz “as áreas tiveram diversidade semelhante”.
Por que é um problema. As duas escalas são comprimidas. Shannon mistura riqueza e equabilidade e pode empatar duas comunidades que diferem em direções opostas, como as parcelas 1 e 19. A forma 1 − D fica espremida perto de 1 em comunidades ricas: 0,975 e 0,966 são 39 e 29 espécies efetivas, uma diferença de 36%. O leitor e a banca leem “semelhante” onde há uma diferença real na dominância e outra, no sentido contrário, na riqueza.
A correção. Relate os índices como números efetivos de espécies (riqueza, exp(H’) e 1/D) e olhe o perfil antes de escrever qualquer conclusão sobre “diversidade”. Se as ordens discordam, diga isso: é um resultado, não um problema.
Se a sua tabela tem índices que não contam a mesma história e você não sabe como escrever, é exatamente esse tipo de dúvida que resolvemos numa consultoria.
Erros comuns na escolha
- Calcular todos e escolher depois. A escolha da medida vem da pergunta, e é declarada no método.
- Misturar bases de log. H’ com log 2 e H’ com log natural não se comparam. O
veganusa log natural por padrão; diga qual usou (Magurran, 2004, p. 107). - Chamar 1 − D e 1/D de “índice de Simpson” sem dizer qual. São escalas diferentes, e o leitor não tem como saber.
- Testar diferença entre dois valores de H’ sem réplicas. O teste t de Hutcheson existe, mas compara duas amostras, não dois tratamentos. Com réplicas independentes, calcule o índice por réplica e use como resposta num modelo (Magurran, 2004, p. 108).
- Usar um índice para corrigir esforço desigual. Nenhum índice corrige amostragem insuficiente. Iguale o esforço antes, como no post sobre comparar riqueza.
O que os índices não dizem
Nenhum desses índices sabe quem são as espécies. Duas áreas podem ter o mesmo perfil de Hill e nenhuma espécie em comum; para isso existe a diversidade beta, que é outra pergunta. Os índices também tratam todas as espécies como igualmente distintas: uma comunidade com dez espécies do mesmo gênero tem o mesmo índice que uma com dez famílias diferentes. Se isso importa para a sua pergunta, Magurran (2004, p. 121-128) descreve medidas de diversidade taxonômica e funcional.
Como escrever a diversidade na dissertação
renyi, pacote vegan [versão]).
Perguntas frequentes
Qual o valor normal do índice de Shannon?
Em dados reais, o índice de Shannon costuma ficar entre 1,5 e 3,5 e raramente passa de 4 (Margalef, 1972, apud Magurran, 2004). Por isso diferenças que parecem pequenas podem esconder comunidades bem diferentes; transforme em exp(H’) para ler em número de espécies.
Qual a diferença entre 1 − D e 1/D no índice de Simpson?
1 − D é a probabilidade de dois indivíduos sorteados serem de espécies diferentes, e quase não varia entre comunidades ricas. 1/D é o número efetivo de espécies dominantes, a ordem 2 dos números de Hill. Diga sempre qual forma usou.
O índice de Shannon tem base log 2 ou log natural?
Qualquer base serve, desde que seja a mesma em todas as comparações. A função diversity() do vegan usa o log natural por padrão. Para transformar em número efetivo de espécies, use a exponencial na mesma base.
Posso comparar índices de diversidade com ANOVA?
Pode, se você tem várias réplicas independentes por tratamento: calcule o índice por réplica e use como resposta. Com uma amostra por tratamento, não há réplica, e o caminho é comparar intervalos de confiança por reamostragem.
Para ir além
Leitura de base: o capítulo sobre diversidade do livro Análises Ecológicas no R, gratuito, os capítulos 4 e 5 de Magurran (2004) e o artigo de Jost (2006), que explica por que os números efetivos são a escala certa. Os números de Hill com rarefação e extrapolação estão no CRAN do iNEXT.
Referências
- CHAO, A. et al. Rarefaction and extrapolation with Hill numbers: a framework for sampling and estimation in species diversity studies. Ecological Monographs, v. 84, n. 1, p. 45-67, 2014.
- CONDIT, R. et al. Beta-diversity in tropical forest trees. Science, v. 295, n. 5555, p. 666-669, 2002.
- HILL, M. O. Diversity and evenness: a unifying notation and its consequences. Ecology, v. 54, n. 2, p. 427-432, 1973.
- JOST, L. Entropy and diversity. Oikos, v. 113, n. 2, p. 363-375, 2006.
- LANDE, R.; DEVRIES, P. J.; WALLA, T. R. When species accumulation curves intersect: implications for ranking diversity using small samples. Oikos, v. 89, n. 3, p. 601-605, 2000.
- MAGURRAN, A. E. Measuring biological diversity. Malden: Blackwell Publishing, 2004.
Travou na escolha do índice de diversidade com os seus dados?
Me mande a sua pergunta. A primeira conversa é sem custo.
Conversar no WhatsApp